
Un proyecto de datos necesita una pregunta útil, una forma de organizar el trabajo y criterios para comprobar si finalmente tenemos o no éxito. Para organizar todo esto, tenemo que emplear una metodología que nos ayude a conectar el análisis técnico con el problema que se quiere resolver y a revisar las decisiones cuando aparecen nuevas evidencias.
¿Qué es un proyecto?
Antes de nada, empecemos definiendo lo que es un proyecto, sin traernoslo todavía a la categoría de proyecto de datos. En general, un proyecto es un esfuerzo temporal orientado a obtener un resultado único. Es temporal porque tiene un comienzo y un fin, los proyectos hay que terminarlos y sino hay que matarlos, pero no podemos vivir con el «muerto en el salón». Un proyecto tiene un objetivo y requiere coordinar actividades, recursos y personas.
Normalmente nos vamos a encontrar con tres KPIs, tres métricas ampliamente empleadas para medir la desviación del proyecto, y obviamente corregirla. Estas métricas las escribo en inglés porque seguramente será así como te las encuentres:
- On time: mide la desviación en tiempo sobre la planificación.
- On budget: mide la desviación sobre el presupuesto, tanto como si te estás pasando como si te está sobrando.
- On scope: mide la desviación sobre el objetivo.
Estas métricas se mide a nivel de tareas, para la situación actual del proyecto, y cuando se tenga una desviación importante en alguna de las métricas puede forzar a una replanificación del proyecto.
Proyecto vs Proceso
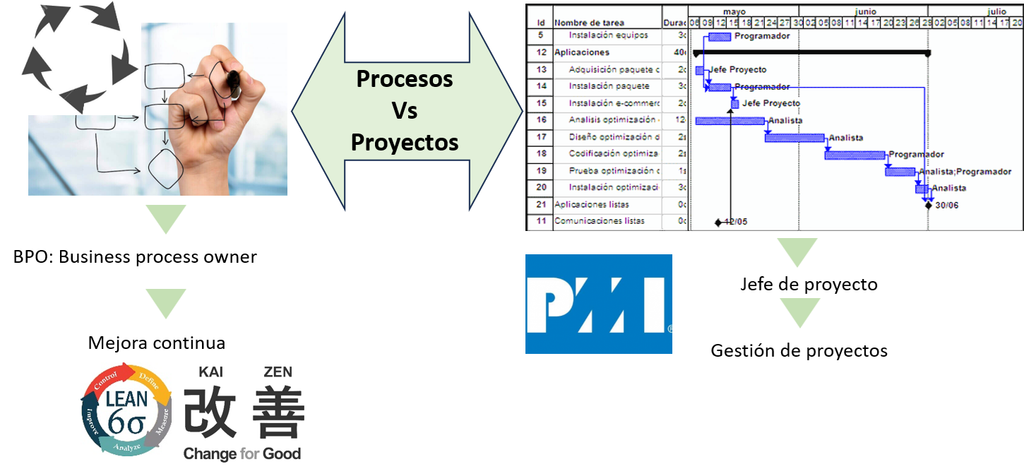
En una empresa, básicamente puedes trabajar en proyectos, procesos o en ambos a la vez. Por ello me parece importante que distingas ambos conceptos claramente, y que sepas discernir en que entorno de juego estás.
Los proyectos son esfuerzos con una duración temporal, mientras que los procesos se repiten constantemente, pueden verse como ciclicos. Por ello, cuando trabajes en proyectos, se te va a pedir eficacia, es decir que entregues lo comprometido en las condiciones acordadas. Empleando las métricas vistas antes, esto puede traducirse en entregar el resultado esperado, dentro del plazo y sin salirse del presupuesto. Por el contrario, cuando trabajes en un proceso, se te va a exigir eficiencia, ya no se trata de entregar lo comprometido, sino de hacerlo mejor a cada ciclo, lo que puede traducirse por entregar más valor o entregar el mismo con menos coste.
Los roles responsables de proyectos, normalmente jefe de proyecto o director de proyecto, aplicaran técnicas de gestión de proyectos, y probablemente estarán englobados en una oficina de proyectos (PMO: Project Management Office). El rol de responsable de proceso suele ser el BPO (Business Process Owner) por sus siglas en inglés, que aplicará técnicas de mejora continua y seguramente pertenecerá al departamento de Calidad.
Metodologías de proyectos
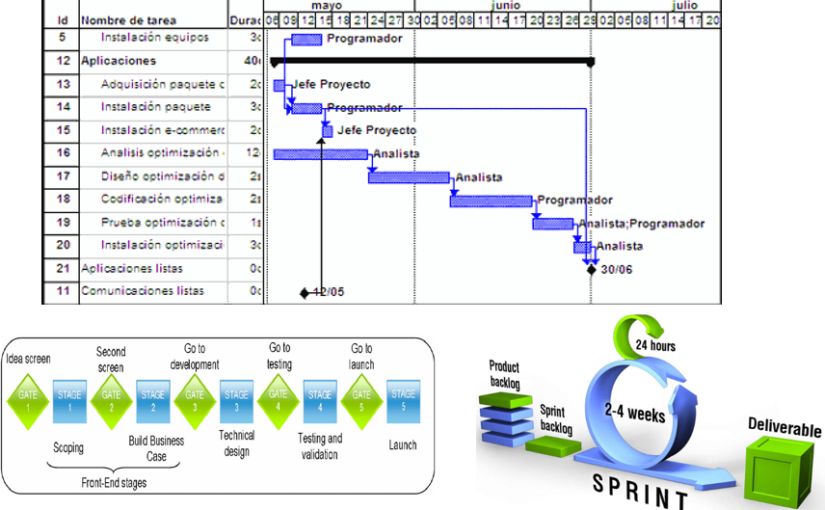
Existen multiples metodologías para la gestión de proyectos, que logicamente tambi´én aplican a los proyectos de datos. De manera un poco general, estas metodologías pueden agruparse en dos familias: las metodologías formal o predictiva, y las metodologías ágiles.
Lo que pretendo en este apartado es darte una comparativa sencilla entre ambas familias, sin entrar en ninguna técnica especifica. Con este propósito, creo que el cuadro siguiente proporciona una comparativa sencilla y clara:
| Formal o predictiva | Ágiles |
|---|---|
| Requerimientos: se cierran al inicio del proyecto, siendo posteriormente muy costoso cambiarlos. | Se obtiene el feedback periódico del cliente y se van adaptando el resultado. |
| Se da mucha importancia a la planificación. | Se planifica el corto. El largo plazo no se cumple nunca. |
| Se siguen una serie de fases predeterminadas. | Se trabaja en lapsos de tiempo corto, entre interacciones con el cliente, en las que se obtiene su feedback. |
| Se distribuye el trabajo en cascada. | Los miembros del equipo se autoasignan el trabajo y toman la responsabilidad del mismo. |
| El objetivo es lograr el producto previsto en el tiempo planificado y costes estimados. | El objetivo es la satisfacción del Cliente |
Cómo elegir la mejor metodología para un proyecto de datos
La metodología debe encajar con las características del proyecto y con la empresa que la aplicará. Influyen la claridad de los requisitos, el acceso a los datos, la incertidumbre técnica y la capacidad del equipo para revisar avances con las personas que tomarán decisiones.
Cuando el resultado está bien definido, una planificación detallada ayuda a coordinar tareas y dependencias. Un cronograma permite concretar entregas y responsabilidades. Aquí empleariamos una metodologías de la familia formal o predictiva.
En cambio, si todavía se desconoce qué información será útil o qué resultados pueden obtenerse, conviene trabajar mediante iteraciones cortas que permitan aprender y ajustar el rumbo. En esta caso, escogeríamos una metodologías de la familia de las águiles.
La elección admite combinaciones. Es posible fijar un presupuesto, una fecha de revisión y unos entregables, mientras el equipo explora distintas formas de preparar los datos o resolver el problema. La planificación aporta coordinación y las iteraciones permiten gestionar la incertidumbre.
CRISP-DM
Finalmente quiero introducir un marco especifico para los proyectos de datos, se trata del framework CRISP-DM, desarrollado por IBM.
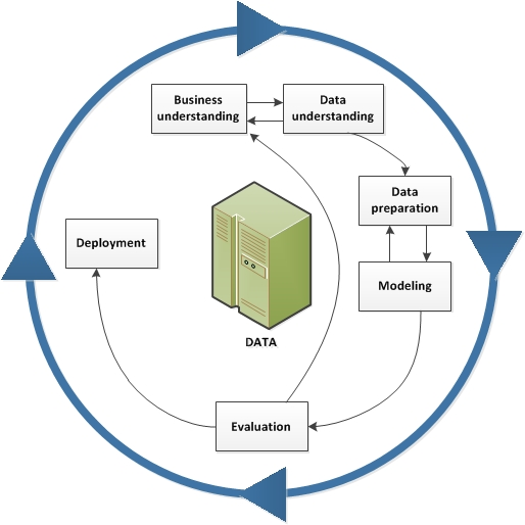
Lo que más me gusta de este framework es las dos primeras fases: business understanding y data understanding. Sin duda, los perfiles hibridos, que sean capaces de entender el negocio y que sepan como trabajar con los datos, serán los más valiosos, los que puedan extraer de los datos información valiosa para el negocio. Hoy en día, todavia hay muchas empresas con muchos datos que no saben como sacarles partido.
Te dejo una breve descripción de las fases de la figura.
- Comprensión del negocio: Se concreta el problema, el uso esperado del resultado y los criterios de éxito. La pregunta inicial es qué decisión se pretende mejorar.
- Comprensión de los datos: Se exploran las fuentes disponibles, su contenido y sus limitaciones. Esta revisión permite valorar si la información sirve para abordar el objetivo.
- Preparación de los datos: Se construye el conjunto de datos que utilizará el análisis. Puede ser necesario combinar fuentes, corregir inconsistencias y transformar variables.
- Modelado: Se prueban técnicas adecuadas al problema y a la información disponible. Las primeras aproximaciones sirven como referencia para valorar alternativas más complejas.
- Evaluación: Se comprueba si los resultados responden a la necesidad inicial. El rendimiento técnico se interpreta junto con las condiciones reales de uso.
- Despliegue: Se entrega el resultado de una forma utilizable. Puede ser un informe, una aplicación a traves de una API o una integración en el trabajo habitual.
Si quieres más detalle de estas fases, lo mejor es que consultes directamente la información que proporciona IBM, que es el creador del framework. Puedes encontrarla en el siguiente enlace.