
Git y GitHub aparecen juntos en muchos tutoriales, pero cumplen funciones diferentes. Git registra versiones de un proyecto en tu equipo, es decir, con Git vamos a trabajar en local. GitHub aloja repositorios Git en Internet, con lo que estaremos trabajando en remoto. Comprender esta diferencia es crucial y permite saber dónde se están registrando los cambios y qué necesitas hacer para conservarlos o publicarlos.
Algunos conceptos previos
Antes de explicar como emplear Git y GitHub en nuestros proyectos, conviene introducir algunos conceptos previos.
- Repositorio: Es el contenedor que almacena todo el historial de un proyecto, incluyendo todos los archivos, carpetas y metadatos de versiones.
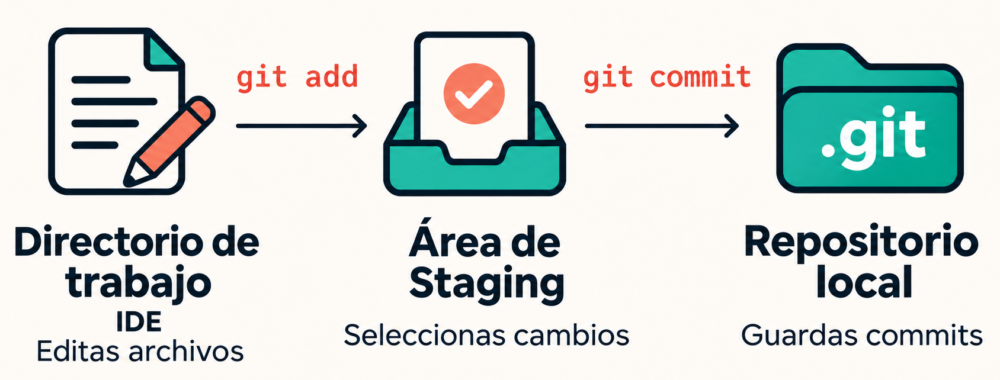
- Staging area (área de preparación): Es una zona donde se seleccionan los cambios que se incluirán en el próximo commit. El comando git add incorpora los cambios a esta zona y git commit guarda la selección en el historial local.
- Commit: Una instantánea del estado completo del proyecto en un momento específico, acompañada de información sobre quién realizó los cambios y por qué.
- Branch (Rama): Una línea de desarrollo independiente que permite trabajar en características diferentes sin afectar el código principal.
- Merge (Fusión): El proceso de combinar cambios de diferentes ramas en una sola, integrando el trabajo realizado en paralelo.
- Push: Es la operación que envia los commits de una rama local a un repositorio remoto, como GitHub, y actualiza allí la rama correspondiente. Se realiza con el comando git push
- Remoto: Una versión del repositorio almacenada en otro lugar (como GitHub) que facilita la colaboración entre múltiples desarrolladores.
Qué guarda un repositorio
Un repositorio Git conserva el historial de los archivos que decides versionar. Estos archivos los has marcado previamente con el comando git add. También puedes indicar a git que ignore determinados ficheros o carpetas, incluyendolos en el fichero .gitignore. Algunos archivos o carpetas de las que no vas a querer versionar son por ejemplo un fichero con tus APIKeys o la carpeta de entorno.
En un proyecto local, la carpeta .git contiene los archivos que vas modificando y has indicado a git que este atento a sus modificaciones, porque vas a versionarlos. Cuando el proyeto llegue a una fase con cierta entidad, puedes decidir que es el momento de hacer un commit y guardar una foto del estado del proyecto.
Un commit registra una instantánea del contenido preparado, junto con datos de autoría, fecha y mensaje. Cada commit que hagas tiene su identificador que permite consultar qué cambió y comparar estados. Además puedes añadir un mensaje al commit que luego te ayude a recordar el estado del proyecto cuando hiciste el commit. El mensaje debería ser explicito y descriptivo de dicha instantanea, por ejemplo: «primera versión sin depurar. Oct 26».
Se trabaja en una rama del proyecto, que es una referencia que avanza con los commits de una línea de desarrollo. La rama principal suele llamarse main, aunque otros proyectos utilizan master. Crear una rama permite separar una tarea, y de esta manera trabajar en la tarea sin afectar a la rama main del desarrollo. Una vez se halla validado el desarrollo de una rama, podemos fusionarla a la rama main con un merge.
Las tres zonas de Git
Trabajando en local con Git, tenemos que distinguir 3 zonas fundamentales:
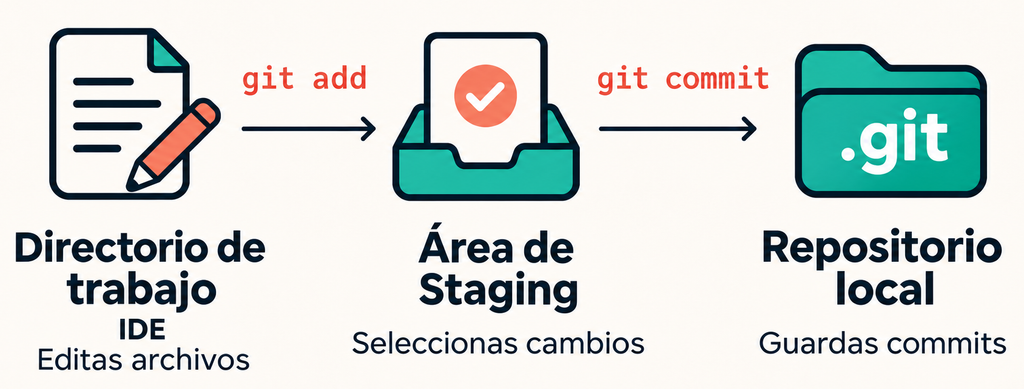
La primera zona es el directorio de trabajo del proyecto, a fin de cuentas ahí es donde están los ficheros del proyecto que vamos a ir modificando, de los que git hará seguimiento.
Con git add, marcamos para git los ficheros que tiene que vigilar, y cada vez que halla una modificación de esos ficheros, los pasará al área de Staging. Una especie de limbo donde los cambios esperan hasta que juzguemos que ya hemos avanzado bastante y conviene guardar una versión del proyecto.
Para guardar la versión actual del proyecto, realizaremos un commit, y la instantanea tomada se guardara en el repositorio local.
El fichero .gitignore
El fichero .gitignore contiene las reglas que Git emplea para decidir qué archivos y carpetas debe ignorar y no hacer seguimiento de ellos. Se suele colocar en la raíz del proyecto y se escribe una regla por línea.
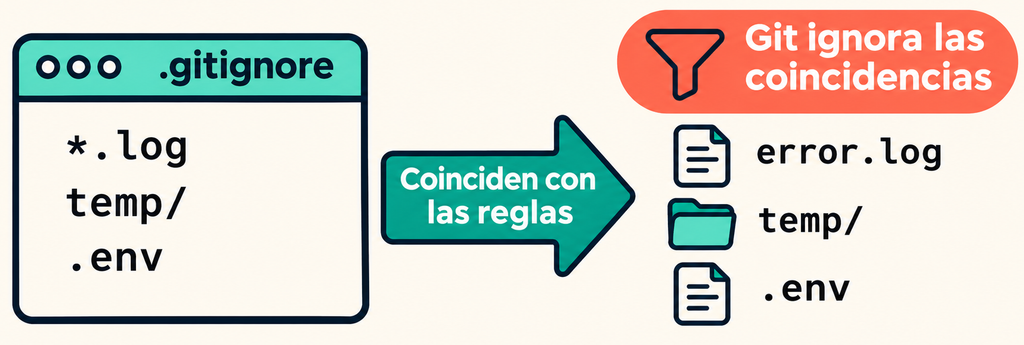
Por ejemplo, las reglas que contiene el fichero .gitignore en la imagen de arriba serían:
- *.log: Indica a Git que debe ignorar los archivos de extensión log.
- temp/: debe ignorarse la carpeta temp y su contenido.
- .env: excluye el fichero de nombre .env
Qué aporta GitHub
GitHub aporta un repositorio en la nube, donde guardar una versión de tu proyecto. Para acceder a ella, vas a usar lo que se conoce como un remoto, que no es otra cosa que un nombre asociado a una dirección, a una url. El nombre más habitual es origin.
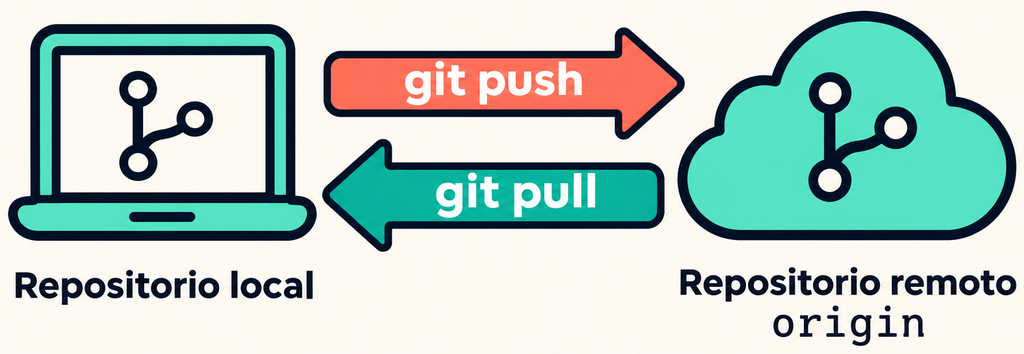
Para guardar una versión del proyecto en el repositorio al que apunta el remoto, es decir, para hacer un commit al repositorio en la nube, se emplea la instrucción git push.
Si lo que queremos es descargar información remota se usa la instrucción git fetch, y git pull para la descarga e integración en la rama local.
Cuando lo que queremos es hacer una copia local del repositorio remoto, emplearemos la instrucción git clone.
Git funciona sin conexión para las operaciones locales. Por el contrario, el acceso a GitHub sí requiere conectividad y permisos. Un repositorio privado limita quién puede acceder al código, pero no justifica guardar contraseñas ni claves en sus commits. Toda la información sensible que no quieres que se suba al remoto debe estar indicada en el fichero .gitignore
Talleres
Para practicar con Git y GitHub, de ire dejando una serie de talleres las próximas semanas